
robots.txtの書き方|コピペで使える記述例と安全な確認手順
この記事の要点
- robots.txtはクロールを制御するファイルで、インデックス削除には使えない
- 基本はUser-agent・Disallow・Allow・Sitemapの4要素で組み立てる
- AI学習用のクローラーは、許可するか拒否するかを各社の公式の説明で確かめて決める
robots.txtを触りたいけれど「1行間違えるとサイト全体が検索から消えるのでは」と手が止まっていませんか。この不安はもっともで、実際に本番で事故が起きやすいファイルです。
この記事では、robots.txtの書き方とdisallowの設定手順を、コピペで使える記述例つきで解説します。AI学習クローラーへの対応や、設定後の確認方法、noindexとの違い、現場でやりがちな失敗までまとめました。読み終わるころには、自社サイトに安全な1枚を用意できる状態になります。
Contents / 目次
robots.txtの結論。まず押さえる4つの要素と役割
結論からお伝えします。robots.txtは「検索エンジンのクローラーに、どのURLを見に来ていいか/来ないでほしいかを伝えるための指示書」です。つまり、サイトの入口に立って交通整理をする案内係のような役割を持ちます。
ここで最初に理解してほしい大事な線引きがあります。robots.txtは「クロール(巡回)を止めるファイル」であって、「インデックス(検索結果への登録)を消すファイルではない」という点です。この違いを取り違えると、後述する失敗の多くにつながります。
robots.txtで扱う指示は、たった4つの要素で組み立てられます。まずはこの4つの役割を押さえましょう。
| 要素 | 意味 | 使いどころ |
|---|---|---|
| User-agent | どのクローラー向けの指示かを指定する | 全クローラーなら「*」、特定ボットなら名前を書く |
| Disallow | クロールを禁止するパスを指定する | 管理画面・検索結果ページ・重複URLなど |
| Allow | Disallowした中で例外的に許可するパス | 禁止フォルダ内の一部ファイルだけ見せたいとき |
| Sitemap | XMLサイトマップの場所を絶対URLで伝える | サイト全体の構造をまとめて知らせる |
robots.txtとは、この4要素を組み合わせてクローラーへの案内ルールを書いたテキストファイルのことです。難しいプログラムではなく、メモ帳で書ける単純なテキストです。だからこそ、記述ミスがそのまま事故につながるので、書き方の型を正しく覚えることが安全への近道になります。
ポイント。robots.txtは必ずサイトのルート(例 https://example.com/robots.txt)に1枚だけ置きます。サブフォルダに置いてもクローラーは読み取りません。
robots.txtの書き方。安全に作る5ステップ
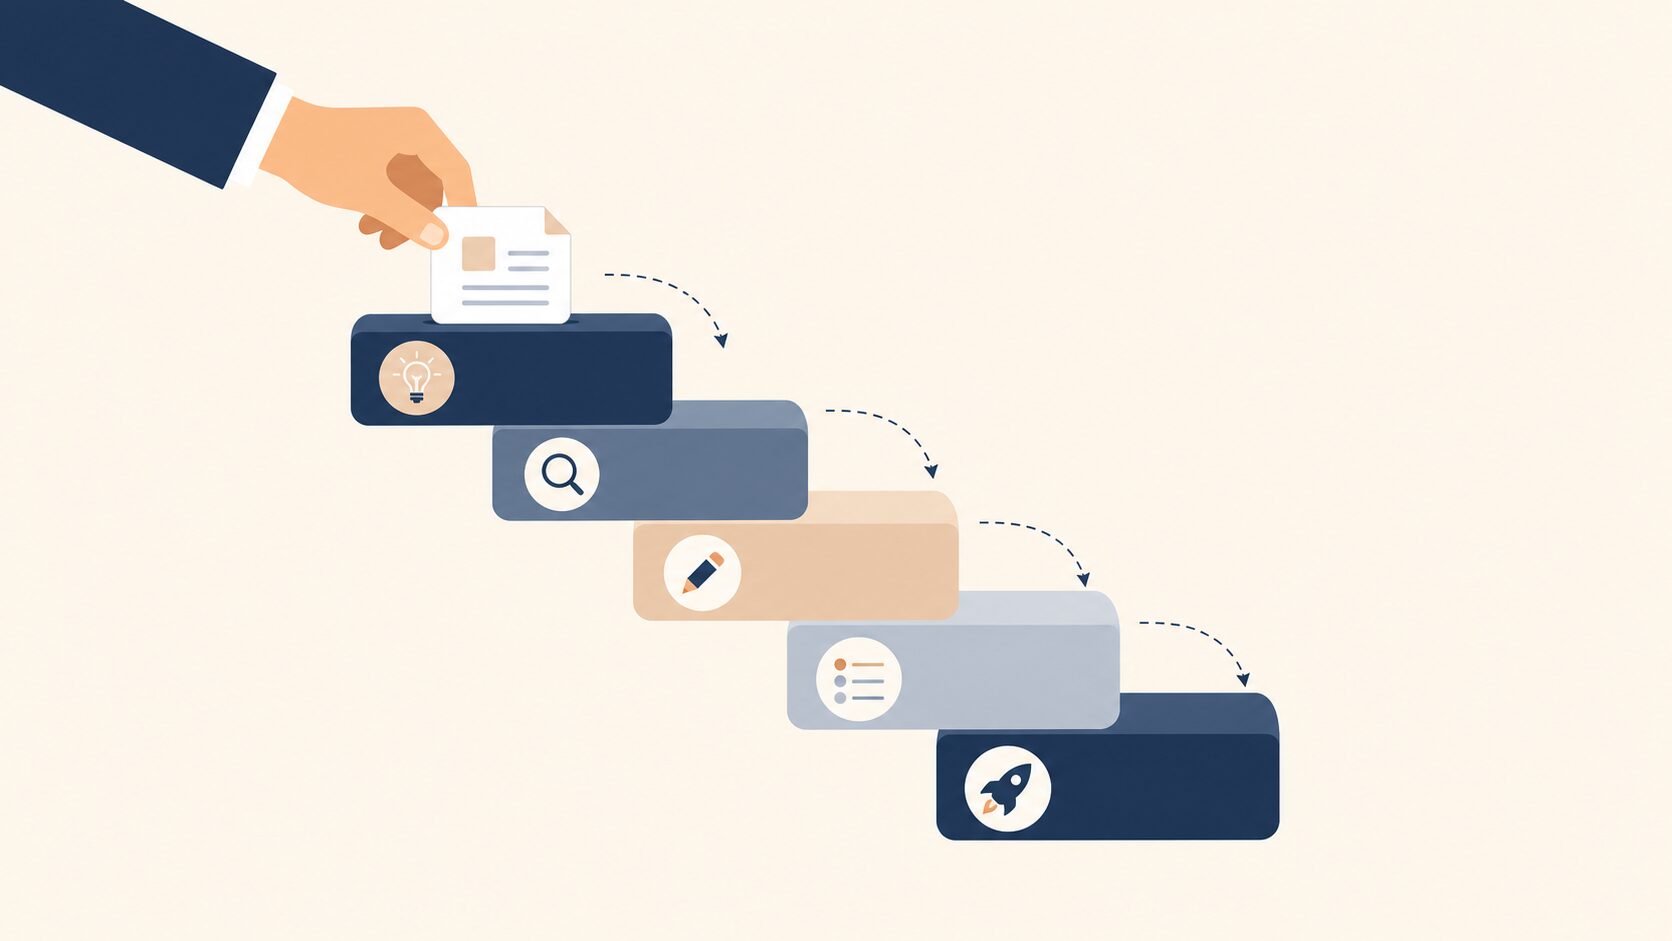
ここからは実際の作り方を、手を動かせる順番で解説します。いきなり本番サーバーを書き換えず、下書き→確認→反映の流れで進めるのが事故を防ぐコツです。次の5ステップで進めましょう。
ステップ1。禁止したいURLを洗い出す
最初にやるのは記述ではなく、洗い出しです。「クローラーに見に来てほしくないURL」を紙かメモに書き出します。ここが曖昧だと、後の記述で迷子になります。
洗い出しの対象になりやすいのは、検索結果に出す必要がなく、かつ数が多くてクローラーの負担になるページです。代表例を挙げます。
- 管理画面・ログイン系:/wp-admin/ など運用者しか使わない領域
- サイト内検索の結果ページ:/?s= のような無限に増えるURL
- カート・購入手続き:/cart/ や /checkout/ など個人ごとのページ
- パラメータ付きの重複URL:並び替えや絞り込みで生成される ?sort= 系
ステップ2。基本の記述をテキストで書く
洗い出しが終わったら、実際の記述に落とします。WordPressサイトを例にした、そのまま出発点に使える基本形がこちらです。自社の状況に合わせて中身を変えてください。
# robots.txt for example.com  最終更新 2026-07-10
# [自社ドメインとパスに合わせて書き換える]

User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php
Disallow: /?s=
Disallow: /cart/
Disallow: /checkout/

Sitemap: https://example.com/sitemap.xml
読み方を補足します。1行目の「#」で始まる行はコメントで、クローラーは無視します。更新日や目的をメモしておくと、後で見返したときに助かります。
「User-agent: *」は「すべてのクローラーに対して」という意味です(Googleの広告用クローラーのAdsBotは「*」に含まれないため、対象にするときは名前を書きます)。続く「Disallow: /wp-admin/」で管理画面を巡回対象から外し、その直後の「Allow」で、動作に必要な admin-ajax.php だけは例外的に許可しています。最後のSitemap行は、「https://example.com/sitemap.xml」のように、プロトコルとドメインを含めた完全なURLで書くのがルールです。
ステップ3。AI学習クローラーへの方針を決める
ここ数年で必要になったのが、この判断です。従来の検索用クローラーとは別に、生成AIの学習に使うためにサイトを巡回するクローラーや、AIの学習に使うかどうかを指定するための名前(トークン)が加わっています。自社の記事や画像をAIの学習に使われたくない場合は、robots.txtで意思表示ができます。
AI学習用クローラーを拒否したい場合の記述例です。代表的なUser-agent名やコントロールトークンを並べています。ただしクローラー名やコントロールトークンは各社の判断で追加・変更されるため、最新の正確な名称は各社の公式ドキュメントで確認してください。
# AI学習用クローラーを拒否する例(名称は各社公式で最新を確認)
User-agent: GPTBot
Disallow: /

User-agent: Google-Extended
Disallow: /

User-agent: CCBot
Disallow: /ここで注意したいのは、AI学習用クローラーの指定が検索インデックスやAI検索の露出にどう影響するかは、各社の仕様によって異なるという点です。たとえばGoogleは、Google の一般的なクローラーのページで、Google-Extendedの指定はGoogle検索での登録やランキングに影響しないと説明しています。OpenAIはOverview of OpenAI Crawlersで、学習に使うGPTBotと、ChatGPTの検索機能にサイトを表示するためのOAI-SearchBotは別々に設定できるとしています。GPTBotを拒否したまま、OAI-SearchBotを許可することもできます。クローラーの名前や指定できる内容は変わることがあるため、実際に設定する前に、各クローラーを提供する会社の公式ドキュメントで最新の内容を必ず確認してください。
robots.txtは「善意のクローラー」への依頼にすぎません。ルールを無視して巡回する悪質なボットも存在します。 どうしても遮断したい相手には、サーバー側やCDNでのIP単位のブロックなど、別の手段が必要になります。
ステップ4。ルートにアップロードする
書き上げたファイルは、必ず「robots.txt」というファイル名(すべて小文字)で保存し、サイトのルートに置きます。FTPソフトやサーバーのファイルマネージャーで、トップページの index ファイルと同じ階層にアップロードします。
WordPressの場合、SEO系プラグインの管理画面から編集できることも多いです。ただしプラグインの画面名やメニューはバージョンで変わるため、正確な操作は使用中プラグインの公式ヘルプで確認してください。どの方法でも、最終的に「https://自社ドメイン/robots.txt」でファイルが表示されればOKです。
ステップ5。反映後に必ず確認する
アップロードしたら、放置せず必ず動作を確認します。まずブラウザのアドレス欄に「https://自社ドメイン/robots.txt」と入力し、書いた内容がそのまま表示されるかを見ます。ここで古い内容やエラーが出るなら、置き場所かキャッシュを疑います。
次に、Google Search Consoleのrobots.txt レポートで、Googleが取得したrobots.txtと前回のクロール日、警告やエラーが出ていないかを確認します。記述の詳しいルールは、Google公式の「robots.txt の書き方、設定と送信」で解説されているので、迷ったら一次情報にあたるのが確実です。 設定を反映したあとの点検には、SEO内部対策のチェックリストもあわせて使うと抜けが減ります。
robots.txtを正しく書くと何が変わるのか
結論として、robots.txtの整備は「検索順位を直接上げる魔法」ではありません。しかし、サイトの土台を安定させ、間接的にSEOを支える効果があります。ここを誤解すると期待外れになるので、正確にお伝えします。
いちばん大きな効果は、クロールバジェットの最適化です。クロールバジェットとは、Googleの説明では「Google によるクロールが可能であり、かつクロールが必要な URL セット」のことです。Googleが1つのサイトのクロールに使える時間とリソースには限界があります。
もし検索結果ページやパラメータ違いの重複URLが大量にあると、クローラーはそうした重要度の低いページの巡回に予算を使い果たしてしまいます。robots.txtで重要でないURLの巡回を止めておけば、クローラーがそうしたURLに時間を使わずに済みます。ただしGoogleは、robots.txtでブロックして空いた分が、そのまま他のページに回るわけではないとしています。また、クロールバジェットを気にする必要があるのは、重複のないページが100万以上ある大規模なサイトや、1万以上あって毎日更新されるサイトなどだと説明しています。
robots.txtで不要な巡回を止めると、次のような状態に近づきます。
- 重要でないURLへの巡回が減っている:検索結果ページや並び替えだけが違うページに、クローラーが時間を使わなくなる
- サーバー負荷が下がっている:クローラーからのリクエストが減り、サーバーの過負荷を避けやすくなる
- 不要な重複URLへの巡回を抑えられる:ただし重複ページの評価集約はrobots.txtの役割ではなく、canonical(rel=”canonical”)やリダイレクトで行う点に注意(Disallowはクロールを止めるだけで、被リンクがあればブロック済みURLもインデックスされ得る)
もう一点、地味ですが重要な効果があります。ステージング環境(公開前のテスト用サイト)を守れることです。robots.txtだけでなく、パスワードによる保護やnoindexも設定しておけば、未完成のページが検索に出てしまう事故を防げます。robots.txtは派手な施策ではありませんが、こうした「守りの効果」でサイト全体の信頼性を底上げしてくれます。スマホでの見え方も含めた土台づくりについては、モバイルファーストインデックス対応のチェック項目も参考になります。
robots.txtでやりがちな失敗と回避法
ここが、この記事でいちばん読んでほしい部分です。robots.txtは1文字の違いが大きな事故になります。起きやすい失敗を、起きる状況・結果・防ぎ方のセットで4つ紹介します。
失敗1。テスト用の全ブロックを本番に持ち込む
これは被害が大きい失敗です。開発中はサイト全体を隠すために「Disallow: /」(全ページ禁止)と書きます。この設定を、公開時に消し忘れて本番サーバーにそのままアップロードしてしまうと、サイト全体がクロールされなくなります。公開したら、ブラウザで robots.txt を開き、「Disallow: /」が残っていないかを確認してください。
失敗2。noindexのつもりでDisallowを使う
「このページを検索結果に出したくない」と思ってDisallowで巡回を止める、という取り違えも起きやすい失敗です。冒頭でも触れた、robots.txtの役割を誤解したパターンです。
Disallowでクロールを止めても、他サイトからリンクされていれば、そのURLは検索結果に表示されることがあります。その場合、クローラーが中身を読めないため、説明文なしで表示されます。
検索結果から確実に消したいページには、robots.txtではなく、そのページ自体に「noindex」の指示(メタタグまたはX-Robots-Tag)を入れます。この場合、noindexを読ませるためにあえてクロールを許可する必要がある点にも注意してください。
失敗3。CSSやJavaScriptをまとめてブロックする
「関係なさそうなフォルダは念のため全部止めておこう」と考え、CSSやJavaScriptの入ったフォルダごとDisallowしてしまうケースです。よかれと思ってやる分、たちが悪い失敗です。
これらのファイルはページの見た目やレイアウトを組み立てる部品です。ブロックするとGoogleがページを正しくレンダリング(描画)できず、ページの内容を適切に分析できなくなります。防ぎ方は、デザインや動作に関わるファイルは止めないと最初から決めておくことです。Search ConsoleのURL検査ツールで[公開 URL をテスト]を行い、[テスト済みのページを表示]の[詳細]でページのリソースが読み込めているかを、[スクリーンショット]で表示が欠けていないかを、定期的に確かめると安心です。
失敗4。大文字・小文字やサブドメインを見落とす
Googleの「Google による robots.txt の指定の解釈」では、パスの一致判定で大文字と小文字を区別すると明記されています。「/Admin/」と「/admin/」は別物として扱われるため、片方だけ書いて安心していると、もう片方が素通りになります。
また、サブドメイン(例 shop.example.com)は、それ自体に別のrobots.txtが必要です。本体ドメインのrobots.txtは、サブドメインには効きません。 防ぎ方は、実際のURLの表記をコピーして正確に書くこと、そしてサブドメインごとに1枚ずつファイルを用意することです。小さな見落としが抜け穴になるので、書いたら実URLで一つずつ照合しましょう。
robots.txt運用の落とし穴と、任せどころの本音
最後に、運用で気をつけたい点をお伝えします。robots.txtは「一度書いたら終わり」のファイルではなくなっています。ここを知っておくと、判断を誤りません。
かつては、robots.txtは一度設定すれば数年放置できるものでした。しかしここ数年で、AIの学習や検索機能に使うクローラーが次々に加わり、状況が変わりました。新しいクローラーが出るたびに「これは許可するのか、拒否するのか」を判断し直す必要が出てきています。 放置していると、知らないうちに自社コンテンツが大量に持ち出される、という事態も起こり得ます。
そしてもう一つ、正直にお伝えしたい妥協点があります。robots.txtで拒否と書いても、それを守るかどうかは各クローラーの良心に委ねられているという事実です。行儀のよい検索エンジンは従いますが、無視して巡回するボットも実在します。
つまり、robots.txtは「お願い」であって「防壁」ではありません。本気で遮断したいなら、サーバーやCDNでのブロックといった、別レイヤーの対策とセットで考える必要があります。
内製と外注の切り分けで言えば、線引きはこうです。小規模なサイトで、止めたいURLが管理画面や検索結果ページ程度なら、この記事の記述例をベースに自社で十分対応できます。一方で、ECサイトや大規模メディアのように、次のような段階になると、1行の判断ミスが売上に直結します。
- パラメータ付きURLが数万単位で存在する
- 複数のサブドメインをまたぐ
- AIクローラーの流入を細かく制御したい
ここは無理に独力で抱え込まず、公開前に第三者の目を通す価値が高い領域です。
判断の目安。「本番のrobots.txtを書き換えるのが怖い」と感じたら、それは慎重さの表れであり正しい感覚です。怖いまま勘で反映するより、確認手順を一つ増やすか、詳しい人に一度見てもらうのが安全です。
よくある質問
robots.txtは必ず作らないといけないの?
必須ではありません。ファイルがなければ、クローラーは全ページを巡回してよいと判断します。 小規模サイトなら無理に作る必要はありませんが、管理画面や重複URLを除外したい、AIクローラーを制御したい場合は用意すると効果的です。
Disallowを書けば検索結果から消える?
消えません。Disallowは巡回を止めるだけで、検索結果への表示を防ぐものではありません。 他サイトからリンクされていればURLが表示されることもあります。 確実に消したいなら、ページ側にnoindexの指示を入れてください。
設定を変えたら、すぐ反映される?
すぐには反映されません。Googleは通常、robots.txtの内容を最大24時間キャッシュに保存し、その後に新しい内容を読み直します。急ぐときは、Search Consoleの「robots.txt レポート」から再クロールをリクエストできます。ほかの会社のクローラーがいつ読み直すかは、各社で異なります。
AIクローラーは全部ブロックすべき?
一律にする必要はありません。自社コンテンツを学習に使われたくないなら拒否、と目的で決めます。指定が何に影響するかは各社の仕様によって異なるため、各クローラーの公式ドキュメントを確認したうえで、切り分けて判断するのがおすすめです。
robots.txtの見直しに不安があるときは
ここまで読んで、「手順は分かったけれど、本番で書き換えるのはやっぱり怖い」と感じた方もいると思います。robots.txtは影響範囲が大きいぶん、その慎重さはとても正しい感覚です。自社サイトのどこを止め、どこを残すべきか、現状を一緒に見直すだけでも構いません。コレットラボのマーケの右腕では、GA4やSearch Consoleなどの数字を毎月確認し、ページの修正など、合意した作業をコレットラボが行います。気になった方はお気軽にお声かけください。まずは現状を聞かせていただくところから始めましょう。
個別のご相談
サービスの選び方やご依頼について、ご相談いただけます。
相談する


